
Diferencia entre árbol de decisión y bosque aleatorio
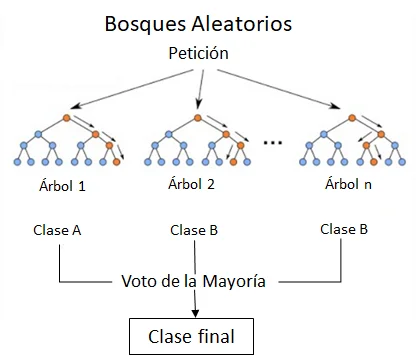
Los árboles de decisión y los bosques aleatorios son dos de las herramientas más utilizadas en el campo del aprendizaje automático y la inteligencia artificial. Ambos métodos se utilizan para resolver problemas de clasificación y regresión, pero tienen diferencias fundamentales en su funcionamiento y en los resultados que producen. En este artículo, exploraremos en profundidad estas diferencias, proporcionando ejemplos y explicaciones que faciliten la comprensión de estos conceptos complejos.
¿Qué es un árbol de decisión?
Un árbol de decisión es un modelo predictivo que utiliza una estructura en forma de árbol para representar decisiones y sus posibles consecuencias. Cada nodo del árbol representa una característica de los datos, mientras que cada rama representa una decisión basada en esa característica. Finalmente, las hojas del árbol representan las predicciones o clasificaciones finales. Este enfoque es intuitivo y fácil de interpretar, lo que lo convierte en una herramienta popular en diversas aplicaciones.
Los árboles de decisión son especialmente útiles cuando se trabaja con datos que tienen una estructura jerárquica. Por ejemplo, en un conjunto de datos sobre clientes, un árbol de decisión podría comenzar preguntando si el cliente es hombre o mujer, luego podría preguntar sobre su edad, y así sucesivamente. Esta secuencia de preguntas permite clasificar a los clientes en diferentes grupos, facilitando la toma de decisiones.
Ventajas de los árboles de decisión
- Interpretabilidad: Son fáciles de entender y visualizar.
- No requieren normalización: Pueden manejar datos de diferentes escalas sin necesidad de preprocesamiento.
- Capacidad para manejar datos categóricos y numéricos: Pueden trabajar con ambos tipos de datos sin problemas.
A pesar de sus ventajas, los árboles de decisión también tienen desventajas. Por ejemplo, son propensos al sobreajuste, lo que significa que pueden ajustarse demasiado a los datos de entrenamiento y no generalizar bien a nuevos datos. Esto puede llevar a predicciones inexactas cuando se aplican a conjuntos de datos no vistos. Además, los árboles de decisión pueden ser inestables; un pequeño cambio en los datos puede resultar en un árbol completamente diferente.
¿Qué es un bosque aleatorio?
Un bosque aleatorio es un conjunto de múltiples árboles de decisión que trabajan juntos para mejorar la precisión de las predicciones. En lugar de construir un solo árbol, un bosque aleatorio genera una gran cantidad de árboles de decisión y luego combina sus resultados. Este enfoque se basa en el principio de que la combinación de múltiples modelos puede reducir el riesgo de sobreajuste y mejorar la precisión general del modelo.
El proceso de creación de un bosque aleatorio implica la selección aleatoria de muestras de datos y características en cada árbol. Esto significa que cada árbol en el bosque es diferente, lo que ayuda a capturar diversas relaciones en los datos. Al final, las predicciones de todos los árboles se combinan, ya sea promediando los resultados (en el caso de la regresión) o tomando la mayoría de las votaciones (en el caso de la clasificación).
Ventajas de los bosques aleatorios
- Mejora en la precisión: Al combinar múltiples árboles, los bosques aleatorios suelen ser más precisos que un solo árbol de decisión.
- Reducción del sobreajuste: La aleatoriedad en la selección de datos y características ayuda a prevenir el sobreajuste.
- Robustez: Son menos sensibles a variaciones en los datos, lo que los hace más estables.
Sin embargo, los bosques aleatorios también tienen sus desventajas. Son más complejos y requieren más recursos computacionales que un solo árbol de decisión. Esto puede ser un factor limitante en situaciones donde la velocidad de entrenamiento y la eficiencia son cruciales. Además, aunque son más precisos, pueden ser más difíciles de interpretar, ya que el resultado final es el resultado de muchos árboles, lo que puede hacer que sea complicado entender cómo se llegó a una decisión específica.
Diferencias clave entre árboles de decisión y bosques aleatorios
Una de las principales diferencias entre los árboles de decisión y los bosques aleatorios es la estructura. Mientras que un árbol de decisión es un solo modelo que toma decisiones basadas en una secuencia de preguntas, un bosque aleatorio es un conjunto de múltiples árboles que trabajan en conjunto. Esta diferencia en la estructura lleva a variaciones significativas en el rendimiento y la precisión de ambos métodos.
Otra diferencia importante es la robustez. Los árboles de decisión son más susceptibles al sobreajuste, lo que significa que pueden ajustarse demasiado a los datos de entrenamiento y fallar al generalizar en nuevos datos. Por otro lado, los bosques aleatorios, al promediar los resultados de múltiples árboles, tienden a ser más robustos y menos propensos al sobreajuste.
Interpretación de resultados
La interpretación de los resultados también varía entre ambos métodos. Un árbol de decisión es fácil de visualizar y entender, lo que permite a los usuarios ver claramente cómo se toman las decisiones. En contraste, un bosque aleatorio, al ser un conjunto de árboles, puede ser más difícil de interpretar. Aunque existen técnicas para visualizar la importancia de las características en un bosque aleatorio, la complejidad del modelo puede hacer que la interpretación sea menos intuitiva.
Aplicaciones de árboles de decisión y bosques aleatorios
Tanto los árboles de decisión como los bosques aleatorios tienen aplicaciones en diversos campos, incluyendo finanzas, salud, marketing y más. En el sector financiero, por ejemplo, los árboles de decisión se utilizan para evaluar la solvencia crediticia de los solicitantes. Un modelo de árbol de decisión puede ayudar a identificar si un solicitante es un buen riesgo o no, basándose en características como el historial crediticio y los ingresos.
Los bosques aleatorios, por su parte, son frecuentemente utilizados en problemas de clasificación más complejos. En el ámbito de la salud, se pueden utilizar para predecir la probabilidad de que un paciente desarrolle una enfermedad en función de múltiples factores, como la edad, el género y el historial médico. La capacidad de los bosques aleatorios para manejar grandes cantidades de datos y características los hace ideales para este tipo de análisis.
Ejemplos prácticos
- Clasificación de correos electrónicos: Los árboles de decisión pueden ser utilizados para clasificar correos electrónicos como "spam" o "no spam" basándose en características como el contenido y el remitente.
- Predicción de ventas: Los bosques aleatorios pueden predecir las ventas de un producto basándose en variables como el precio, la publicidad y la temporada.
- Diagnóstico médico: Los árboles de decisión pueden ayudar a los médicos a tomar decisiones sobre diagnósticos basándose en síntomas y resultados de pruebas.
Ambos métodos tienen sus propias ventajas y desventajas, y la elección entre un árbol de decisión y un bosque aleatorio depende del problema específico que se esté abordando. Para problemas simples y fáciles de interpretar, un árbol de decisión puede ser suficiente. Sin embargo, para problemas más complejos donde la precisión es clave, un bosque aleatorio puede ser la mejor opción.
Comparación de rendimiento
En términos de rendimiento, los bosques aleatorios generalmente superan a los árboles de decisión en tareas de clasificación y regresión. Esto se debe a su capacidad para reducir la varianza y mejorar la precisión a través de la combinación de múltiples árboles. Sin embargo, el rendimiento puede variar según el conjunto de datos y la complejidad del problema. En algunos casos, un árbol de decisión puede ser más eficiente y suficiente para resolver un problema específico.
Los bosques aleatorios, al ser más complejos, requieren más tiempo de entrenamiento y recursos computacionales. Esto significa que en situaciones donde se necesita una respuesta rápida, un árbol de decisión puede ser preferible. Sin embargo, en entornos donde la precisión es primordial, los bosques aleatorios son a menudo la opción preferida.
Evaluación del modelo
La evaluación de los modelos de árboles de decisión y bosques aleatorios se realiza a través de métricas como la precisión, el recall y la f1-score. Estas métricas ayudan a determinar qué tan bien está funcionando el modelo y si está haciendo predicciones precisas. Los bosques aleatorios tienden a tener mejores puntuaciones en estas métricas debido a su naturaleza de conjunto, lo que les permite manejar mejor los datos ruidosos y las variaciones en los conjuntos de datos.
Consideraciones finales sobre la elección del modelo
Al elegir entre un árbol de decisión y un bosque aleatorio, es importante considerar varios factores. Uno de los más relevantes es la complejidad del problema. Para problemas simples, un árbol de decisión puede ser suficiente y más fácil de interpretar. Sin embargo, para problemas más complejos o cuando se necesita alta precisión, un bosque aleatorio puede ser la mejor opción.
Otro factor a considerar es la disponibilidad de recursos computacionales. Los bosques aleatorios requieren más tiempo y recursos para entrenar, lo que puede ser un factor limitante en algunos entornos. la elección entre estos dos modelos depende de las necesidades específicas del proyecto, los recursos disponibles y el nivel de precisión requerido.
El futuro de los modelos de decisión
Con el avance de la tecnología y el crecimiento de los datos, los modelos de decisión como los árboles de decisión y los bosques aleatorios seguirán desempeñando un papel importante en el aprendizaje automático. A medida que surjan nuevos algoritmos y técnicas, es probable que veamos mejoras en la precisión y eficiencia de estos modelos. Además, la combinación de modelos, como el uso de bosques aleatorios junto con otros algoritmos, podría llevar a resultados aún más precisos y útiles en el futuro.