
Diferencia entre NameNode y DataNode en Hadoop
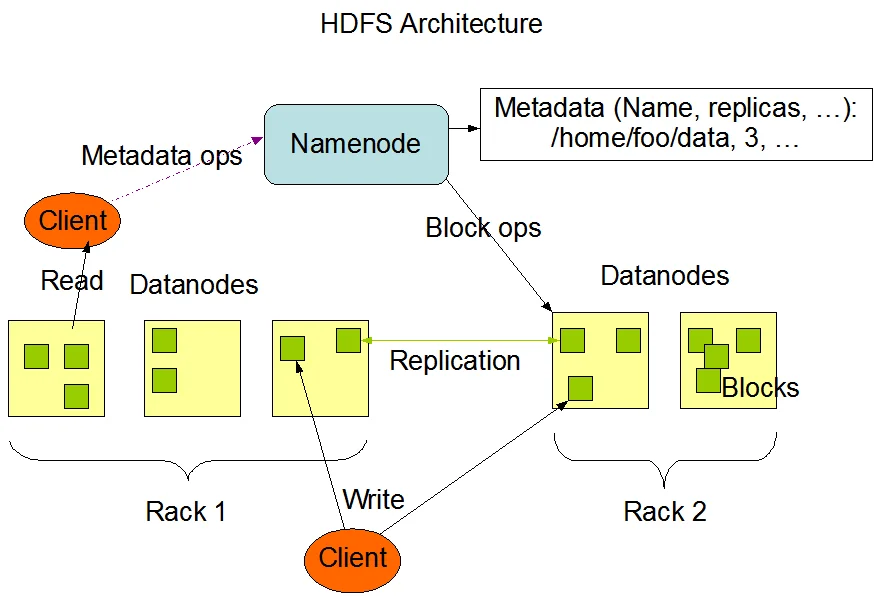
En el ecosistema de Hadoop, dos componentes principales son fundamentales para el almacenamiento y la gestión de datos: NameNode y DataNode. Estos dos elementos desempeñan roles diferentes pero complementarios en el sistema de archivos Hadoop Distributed File System (HDFS). Entender la diferencia entre ellos es crucial para cualquier persona que desee trabajar con Hadoop, ya que estos componentes son esenciales para el funcionamiento efectivo del marco de trabajo. En este artículo, exploraremos en profundidad las funciones, características y diferencias entre NameNode y DataNode, así como su importancia en el manejo de grandes volúmenes de datos.
¿Qué es NameNode?
NameNode es el componente maestro en el sistema de archivos HDFS. Su principal responsabilidad es gestionar la estructura del sistema de archivos y el metadato asociado a los archivos almacenados en el clúster. Esto significa que NameNode mantiene un registro de dónde se encuentran los bloques de datos en los diferentes DataNodes. A través de esta gestión, NameNode puede ofrecer una vista organizada y jerárquica de los archivos, permitiendo a los usuarios y aplicaciones acceder a los datos de manera eficiente. La importancia de NameNode radica en su función de orquestador, que asegura que los datos estén organizados y accesibles.
Una de las características clave de NameNode es que no almacena los datos reales de los archivos. En su lugar, almacena la información sobre la ubicación de los bloques de datos en los DataNodes. Esto implica que NameNode tiene una estructura de datos en memoria que se conoce como imagen del sistema de archivos, la cual contiene todos los metadatos necesarios para gestionar los archivos. Sin embargo, debido a esta arquitectura, NameNode puede convertirse en un único punto de fallo, lo que significa que si NameNode falla, el acceso a los datos se interrumpe.
¿Qué es DataNode?
Por otro lado, DataNode es el componente esclavo en HDFS, y su función principal es almacenar los bloques de datos reales. Cada DataNode se encarga de almacenar una parte del archivo y proporciona acceso a esos bloques cuando se requieren. A diferencia de NameNode, que gestiona metadatos, DataNode se centra en la eficiencia del almacenamiento y la recuperación de datos. Los DataNodes son responsables de la lectura y escritura de datos, y también de la replicación de bloques para garantizar la disponibilidad y la tolerancia a fallos en el sistema.
Un aspecto importante de los DataNodes es que se comunican constantemente con el NameNode para informar sobre el estado de los bloques de datos que almacenan. Esto incluye información sobre qué bloques están disponibles, si hay bloques corruptos y si necesitan ser replicados. Esta comunicación es esencial para mantener la integridad de los datos y asegurar que el sistema funcione sin problemas. Además, cada DataNode tiene la capacidad de manejar múltiples peticiones de lectura y escritura simultáneamente, lo que permite un acceso rápido y eficiente a los datos almacenados.
Funciones de NameNode y DataNode
Las funciones de NameNode y DataNode son complementarias, y su colaboración es esencial para el funcionamiento de HDFS. NameNode actúa como el director del sistema de archivos, gestionando la estructura y el acceso a los datos, mientras que DataNode se encarga de la ejecución real de las operaciones de lectura y escritura de datos. Esta división de responsabilidades permite que Hadoop maneje grandes volúmenes de datos de manera eficiente y escalable.
Funciones de NameNode
- Gestión de metadatos: NameNode almacena información sobre la ubicación de los bloques de datos y la estructura del sistema de archivos.
- Control de acceso: NameNode gestiona los permisos de acceso a los archivos y directorios en HDFS.
- Replicación de bloques: NameNode determina cuántas copias de cada bloque se deben mantener y gestiona la replicación.
- Recuperación de fallos: En caso de que un DataNode falle, NameNode se encarga de replicar los bloques almacenados en ese nodo en otros nodos disponibles.
Funciones de DataNode
- Almacenamiento de datos: DataNode se encarga de almacenar los bloques de datos reales que componen los archivos.
- Lectura y escritura: DataNode procesa las solicitudes de lectura y escritura de los bloques de datos.
- Comunicación con NameNode: DataNode informa a NameNode sobre el estado de los bloques que almacena.
- Replicación de bloques: DataNode también participa en la replicación de bloques, asegurando que haya copias disponibles en otros nodos.
Diferencias clave entre NameNode y DataNode
Las diferencias entre NameNode y DataNode son evidentes en sus funciones y responsabilidades. Mientras que NameNode actúa como el cerebro del sistema, gestionando la estructura y el acceso a los datos, DataNode se ocupa de la parte física del almacenamiento. A continuación, exploraremos algunas de las diferencias clave que distinguen a estos dos componentes.
1. Rol en el sistema
NameNode es el componente maestro que gestiona el sistema de archivos y los metadatos, mientras que DataNode es el componente esclavo que almacena los bloques de datos. Esta diferencia en roles es fundamental para el diseño de HDFS, ya que permite una gestión eficiente de los datos a gran escala.
2. Almacenamiento de datos
NameNode no almacena los datos reales, solo la información sobre dónde se encuentran. En contraste, DataNode almacena los bloques de datos reales que componen los archivos. Esta diferencia implica que el NameNode tiene una carga de trabajo diferente, centrada en la gestión, mientras que DataNode se ocupa de la ejecución y el almacenamiento.
3. Punto de fallo
NameNode puede convertirse en un único punto de fallo, lo que significa que si falla, el sistema de archivos se vuelve inaccesible. Por otro lado, DataNodes pueden fallar sin que el sistema se detenga, ya que los bloques de datos están replicados en otros nodos. Esta característica de HDFS proporciona una mayor resiliencia y disponibilidad en el sistema.
4. Escalabilidad
La arquitectura de HDFS permite escalar fácilmente el número de DataNodes según sea necesario. A medida que se añaden más nodos, el sistema puede almacenar y procesar más datos. Sin embargo, el NameNode tiene limitaciones en cuanto a la cantidad de metadatos que puede manejar, lo que puede ser un factor limitante en la escalabilidad del sistema.
Importancia de NameNode y DataNode en Hadoop
La importancia de NameNode y DataNode en el ecosistema de Hadoop no puede subestimarse. Ambos componentes son cruciales para la gestión efectiva de grandes volúmenes de datos. NameNode, al ser el gestor de metadatos, permite que los usuarios y aplicaciones accedan a los datos de manera organizada y eficiente. Sin su función, el sistema de archivos sería caótico y difícil de manejar.
Por otro lado, DataNode proporciona la infraestructura necesaria para almacenar y acceder a los datos reales. Sin DataNodes, los datos no tendrían un lugar donde residir, lo que haría que el sistema de archivos fuera inútil. La colaboración entre NameNode y DataNode permite a Hadoop ser un sistema de almacenamiento y procesamiento de datos altamente efectivo y escalable.
Escenarios de uso
Los escenarios de uso de Hadoop, y por ende de NameNode y DataNode, son variados y abarcan múltiples industrias. Desde análisis de datos hasta procesamiento de grandes volúmenes de información, la arquitectura de Hadoop se adapta a diversas necesidades. En el ámbito empresarial, las organizaciones utilizan Hadoop para almacenar y analizar datos de clientes, transacciones y operaciones, permitiendo una mejor toma de decisiones basada en datos.
Además, en el campo de la investigación, los científicos utilizan Hadoop para procesar grandes conjuntos de datos, como secuencias genéticas o datos climáticos. La capacidad de escalar y manejar grandes volúmenes de datos hace que Hadoop sea una opción popular en estos contextos. En todos estos escenarios, la interacción entre NameNode y DataNode es esencial para garantizar que los datos sean accesibles y estén bien organizados.
Desafíos y consideraciones
A pesar de las ventajas que ofrece Hadoop, también existen desafíos y consideraciones que deben tenerse en cuenta al implementar NameNode y DataNode. Uno de los principales desafíos es la gestión del NameNode, que puede convertirse en un punto de fallo crítico. Para mitigar este riesgo, las organizaciones pueden implementar soluciones de alta disponibilidad que permitan que múltiples instancias de NameNode trabajen juntas, proporcionando redundancia y resiliencia.
Otro desafío es la gestión del espacio de almacenamiento en DataNodes. A medida que los datos crecen, es fundamental monitorear el uso del espacio y asegurarse de que los DataNodes tengan suficiente capacidad para almacenar los bloques de datos. La falta de espacio puede llevar a problemas de rendimiento y a la pérdida de datos si no se gestionan adecuadamente.
Conclusiones sobre NameNode y DataNode
La comprensión de NameNode y DataNode es esencial para cualquier persona que desee trabajar con Hadoop. Ambos componentes desempeñan roles críticos en la gestión y almacenamiento de datos, y su interacción es lo que permite a Hadoop ser una herramienta poderosa para el procesamiento de grandes volúmenes de información. Conociendo sus funciones, diferencias y desafíos, los usuarios pueden aprovechar al máximo el potencial de Hadoop y optimizar sus flujos de trabajo de datos.
NameNode y DataNode son pilares fundamentales en el ecosistema de Hadoop. Su colaboración permite que el sistema funcione de manera efectiva y escalable, lo que es esencial en un mundo donde los datos están en constante crecimiento y evolución. Con una comprensión clara de cómo funcionan estos componentes, los usuarios pueden tomar decisiones informadas sobre cómo implementar y gestionar sus soluciones de almacenamiento y procesamiento de datos.